
模型与用量
LenBot 只需配置一个聊天模型即可运行完整对话循环。本页说明模型服务商协议、多用途模型分工、向量检索、语音转写与每日 token 上限。
服务商与协议
在模型 → 服务商中管理接口连接。每项连接包含名称、协议、接口地址、密钥和可选的网络代理(支持 HTTP/HTTPS 代理,留空直连)。保存前可点击读取模型列表并按名称搜索,也可直接点击测试文本(1 次请求)或测试工具调用(2 次请求)验证连通。
| 协议标识 | 面板名称 | 适用接口 |
|---|---|---|
openai-chat | OpenAI 兼容聊天 | DeepSeek 及各类兼容 /v1/chat/completions 的服务商 |
openai-responses | OpenAI Responses | OpenAI /v1/responses 接口 |
anthropic | Anthropic Messages | Anthropic /v1/messages 及兼容接口 |
gemini | Gemini GenerateContent | Google Gemini 原生接口 |
openai-embeddings | OpenAI 兼容向量 | 记忆、资料与说法检索使用的 /v1/embeddings 接口 |
openai-audio | OpenAI 兼容语音转写 | 群语音消息转写使用的 /v1/audio/transcriptions 接口 |
网页搜索与网页读取服务使用的第三方密钥连接同样在此页统一管理,见联网与工具。协议请求字段与适配细节见仓库中的模型协议说明。
模型用途
在模型 → 用途中为不同工作分配模型。除聊天为必填项、语音转写需显式启用外,其余用途未单独配置时均自动跟随聊天模型。
| 用途名称 | 配置键 | 职责 | 未单独配置时 |
|---|---|---|---|
| 聊天 | mind | 群聊回合决策、工具调用、会话回想压缩、后台记忆整理与群内学习 | 必填 |
| 看图 | vision | 为不支持图片输入的聊天模型生成图片描述,以及标注群内表情 | 聊天模型勾选支持图片输入时由聊天模型直接看图;否则不看图片 |
| 记忆摘要 | memory | 生成本地记忆各目录的摘要与本群画像 | 跟随聊天模型 |
| 插件生成 | learner | 供插件通过 ctx.generate(..., role="learner") 发起单次文本生成 | 跟随聊天模型 |
| 后台任务 | worker | Docker 后台任务容器中编程助手调用的模型 | 跟随聊天模型 |
| 语音转写 | asr | 将群聊语音消息转写为文本 | 关闭语音转写 |
常用生成参数说明:
- 支持图片输入:在聊天模型中开启后,模型直接读取预处理后的图片(单轮上下文最多保留最近 4 张图片,跨轮再次查看同一图片时复用本地缓存)。关闭该开关且配置了看图模型时,改由看图模型转述画面文字描述。
- 首轮请求的思考强度(
quick_reasoning_effort):勾选首轮请求使用低档思考(推荐)后,收到新消息后的第一步请求、后台整理回合以及回想压缩均使用low档思考强度;回合内调用工具后的续接步骤使用主思考强度(reasoning_effort)。 - 思考开关与思考额度:部分
openai-chat兼容服务通过thinking.type控制推理开关,可在思考开关中显式选开或关(默认不发送该字段)。思考强度与思考额度(token 数)二选一填写。 - 失败重试等待(秒):新建用途默认填
2, 5,遇到 HTTP429、5xx或底层连接中断时依次等待 2 秒、5 秒自动重发;单次请求达到超时秒数时不再重试,留空表示不重试。面板中的连通测试不执行自动重试。 - 历史续接方式:默认选择省去思考内容(
omit);若所用服务商要求多步工具调用必须原样回传上一轮推理字段,可在更多参数中改为原样保留(native)。更换聊天模型后,已结束回合的工具记录自动转为普通历史文本。 - 回想最大长度:整理回想的输出上限默认等于聊天模型的最长输出,也可在系统 → 设置 → 高级 → 上下文压缩 → 回想最大长度中单独指定。开启思考且未显式指定思考额度时,一半输出额度分配给回想正文,另一半留给模型思考。
模型调用失败排查
宿主在发出请求前会先按用途配置的上下文长度估算输入与输出总和,超出窗口时直接中止并给出估算值与调整项。服务端返回错误时,面板按以下分类提示处理方向:
| 错误类型 | 排查方向 |
|---|---|
| 输出额度用尽 | 调大该用途的最长输出(开启思考的模型需同时留出思考 token 空间) |
HTTP 401 / 403 | 核对服务商密钥及当前账号对该模型的访问权限 |
HTTP 429 | 触发服务商速率或并发限制,稍后重试、检查服务商配额,或在系统 → 设置 → 连接 → 更多设置中调小同时进行的模型请求数 |
HTTP 404 或模型不存在 | 核对接口地址路径(例如是否缺少 /v1)并点击读取模型列表核实模型 ID |
HTTP 5xx | 上游服务商或中转网关故障,可从错误详情复制 request id 联系服务方 |
| 超过实际上下文窗口 | 用途中填写的上下文长度大于模型真实上限,按服务商文档调小 |
| 连接失败或响应超时 | 检查接口地址、网络连通性与服务商网络代理,或适当调大超时 |
总览的待处理事项会将同一服务商、同一用途的同类报错合并展示,点开可查看最近一次原始响应;系统 → 日志 → 运行健康按用途列出近 7 天最近一次成功与失败时间。
向量检索
长期记忆与资料检索默认使用全文匹配。需要按语义检索时,准备一个兼容 openai-embeddings 协议的向量服务。例如通过仓库随附的 Compose 配方在本机启动 Ollama:
docker compose -f deploy/current/services.compose.yaml up -d embeddings
docker exec lenbot-embeddings ollama pull bge-m3:567m随后在模型 → 服务商中添加协议为OpenAI 兼容向量、地址为 http://127.0.0.1:11434/v1 的服务商;进入模型 → 向量模型,开启记忆和资料向量(模型填 bge-m3:567m,向量维数填 1024),点击测试向量接口确认返回维数后保存并重启。
开启了群内学习的群还可在同一页按群配置学习向量。后续更换向量服务的接口地址、模型名或维数后,需按重建索引更新已有向量。
语音转写
理解群内语音消息需要一个兼容 openai-audio 协议的语音识别服务:
- 在模型 → 服务商中添加OpenAI 兼容语音转写服务商,并在模型 → 用途中启用语音转写。
- 在需要转写的群中打开群聊 → 设置 → 参与方式 → 自动转写语音消息(角色允许
transcribe工具时,模型也可按需主动转写指定语音)。
在 macOS 本机编译部署 whisper.cpp(whisper-server)的步骤及大体积语音的帧上限计算见仓库中的 ASR 部署说明。
用量与上限
模型 → 用量与上限按今天与本月统计输入、缓存命中、输出与总 token 数,分别提供按模型和按群和用途明细表,并支持设置每日 token 上限(可设所有群每日合计,也可按群单独设置)。
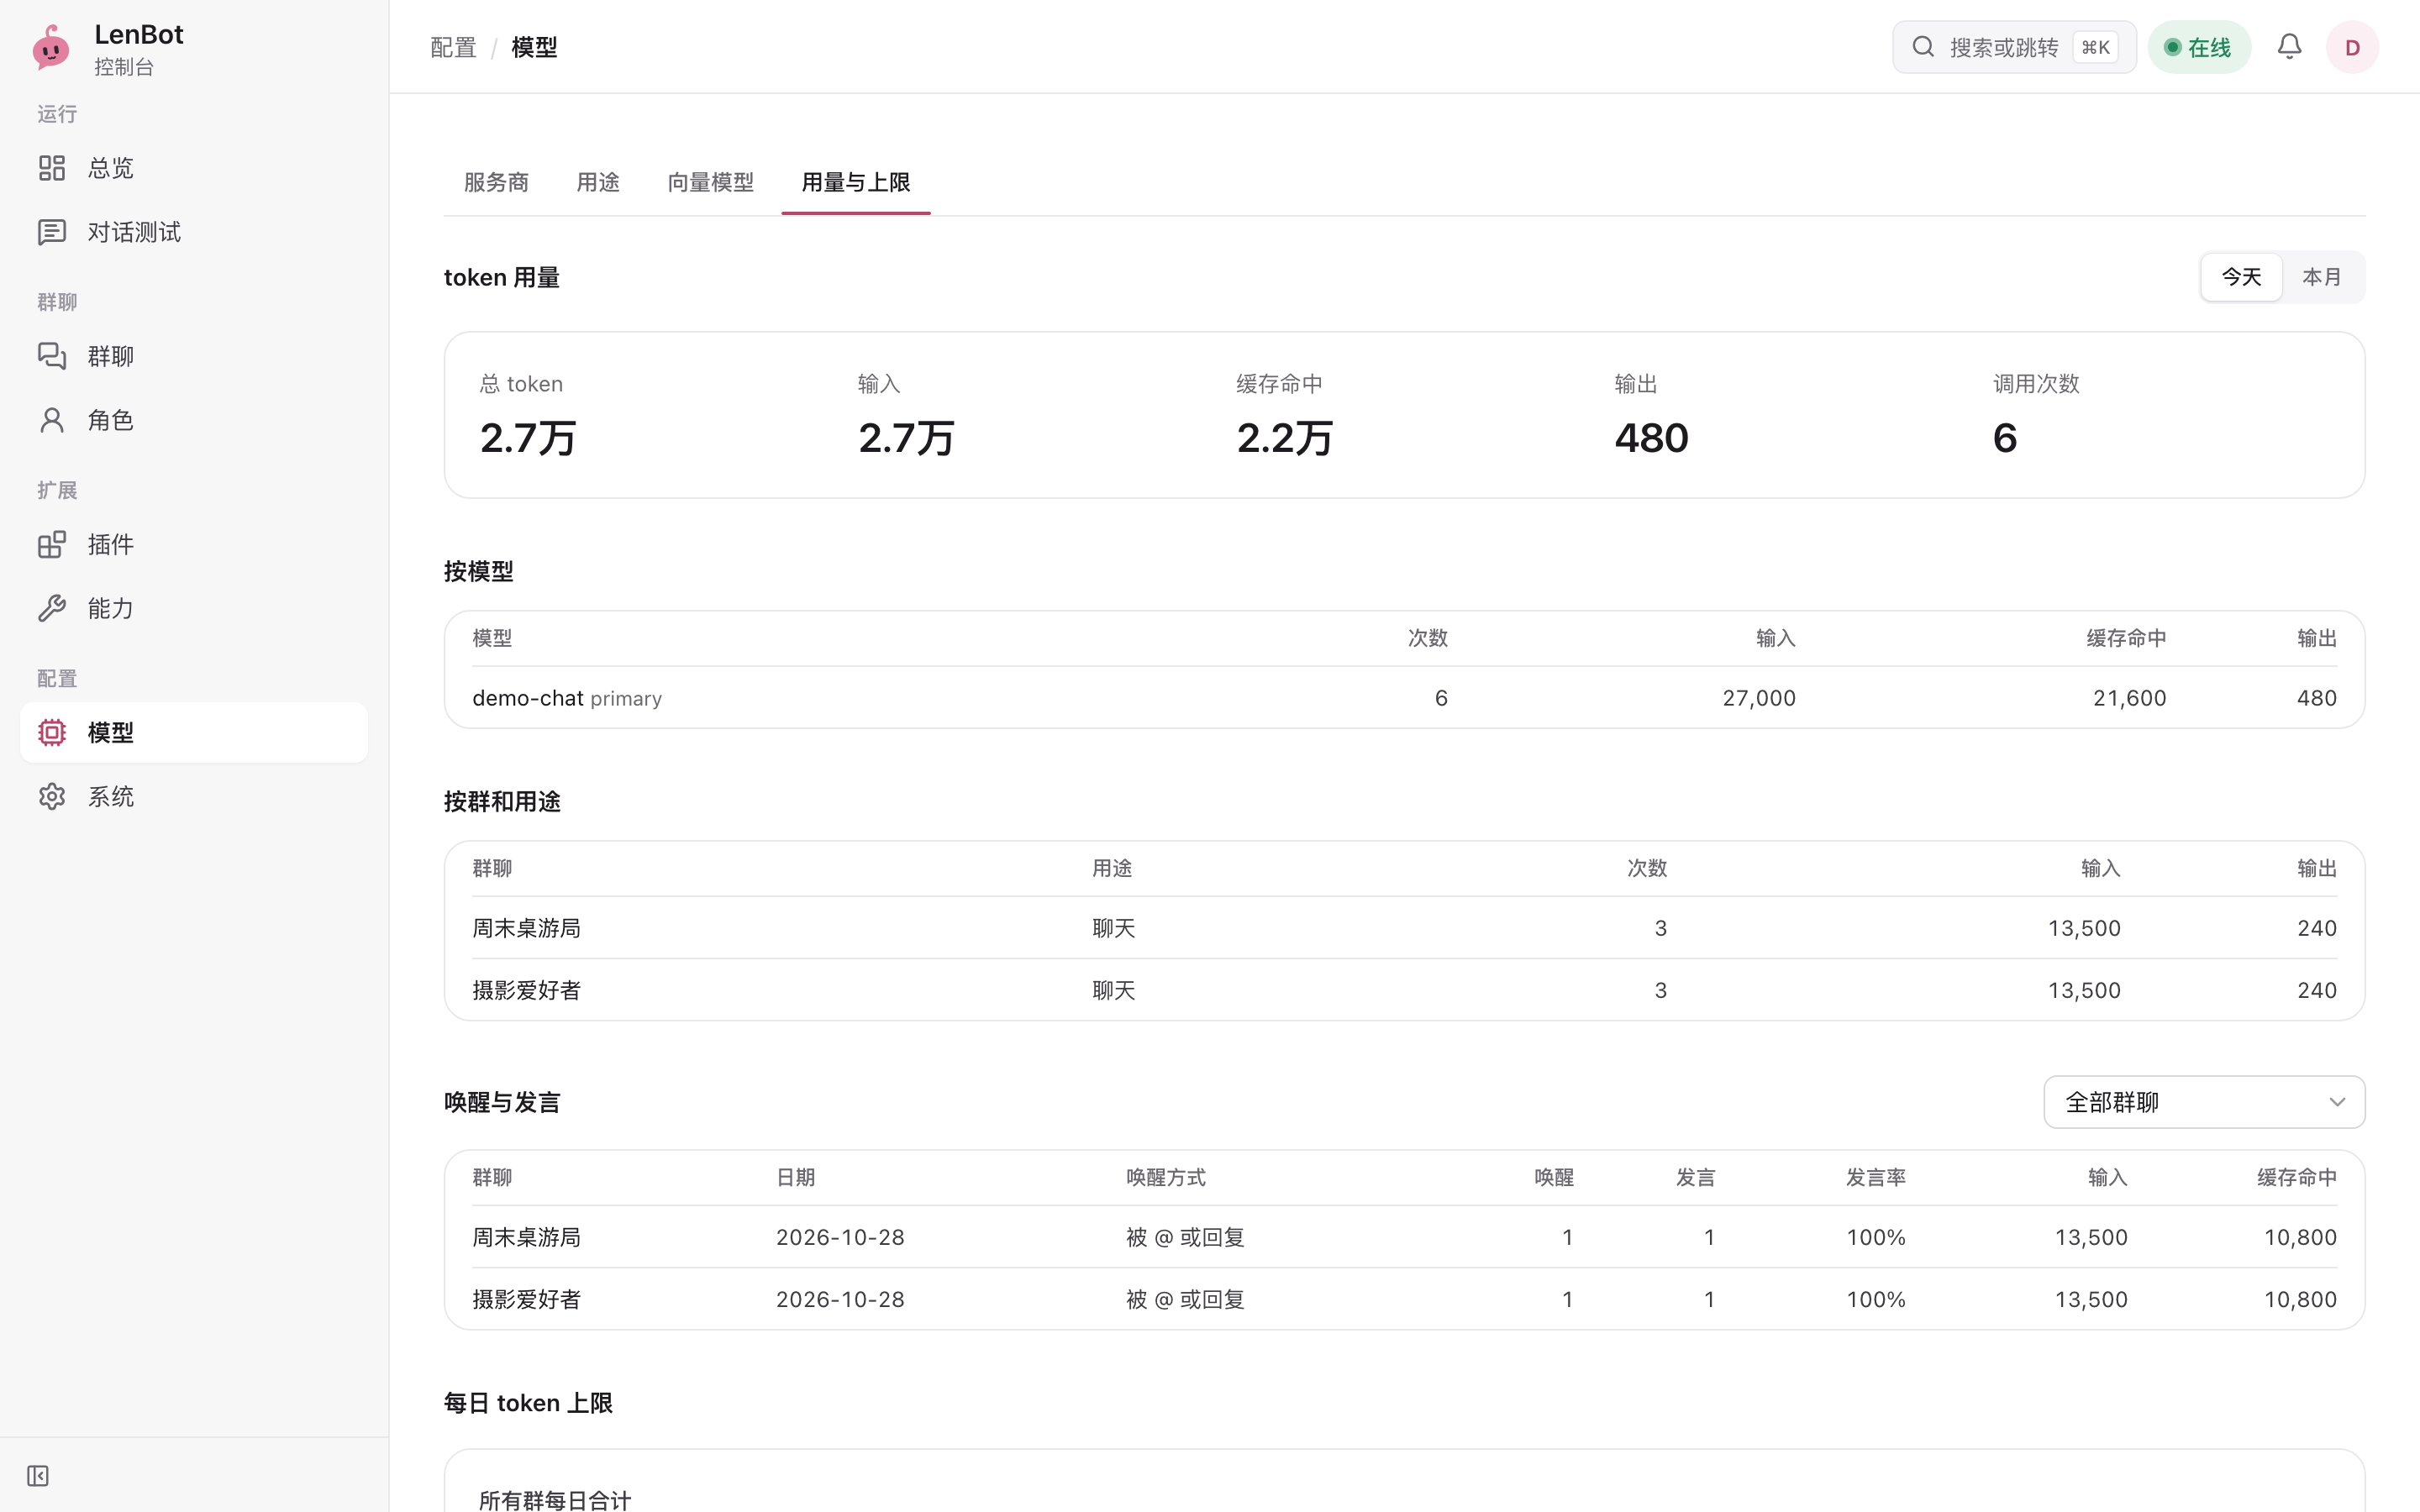
同一页底部的唤醒与发言表按群聊、日期和唤醒方式汇总唤醒次数、发言次数、发言率,以及聊天模型的输入 token 与缓存命中 token。每次进入回合计 1 次唤醒;回合内发出文字、单独发送表情或给消息贴表情均计为有发言回合。
每次模型请求完成时,宿主都会将时间戳、场景、用途、服务商、模型名及服务端报告的 token 数写入独立的 usage 账本表。数据保留任务清理过期的模型请求快照正文时不会删除账本记录。语音转写与向量调用单独展示调用记录,不计入每日聊天 token 限额。